Tipos de aprendizaje automático: guía para entender sus principales métodos
Tipos de aprendizaje automático
El aprendizaje automático —o machine learning— es una rama de la inteligencia artificial que permite a los sistemas aprender patrones a partir de datos y utilizar lo aprendido para realizar predicciones o tomar decisiones. En lugar de programar cada instrucción de forma explícita, se entrena un modelo con ejemplos para que pueda resolver una tarea.
Hay distintos tipos de aprendizaje automático. La diferencia principal está en cómo se presentan los datos durante el entrenamiento y en la información que recibe el modelo. A continuación, repasamos los enfoques más habituales y sus aplicaciones.
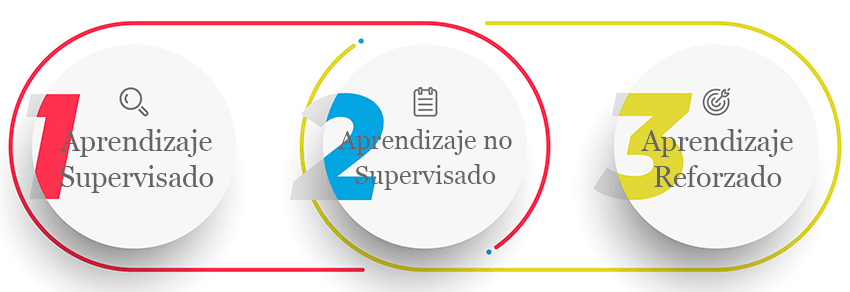
Aprendizaje supervisado
En el aprendizaje supervisado, el modelo se entrena con datos que incluyen tanto la información de entrada como la respuesta correcta, conocida como etiqueta. Al comparar sus predicciones con esas respuestas, el sistema ajusta sus parámetros para reducir los errores.
Este enfoque se utiliza principalmente para dos tipos de tareas:
- Clasificación: asigna los datos a categorías. Por ejemplo, puede identificar si un correo electrónico es legítimo o no deseado.
- Regresión: estima un valor numérico, como el precio probable de una vivienda o la demanda de un producto.
El aprendizaje supervisado es útil cuando se dispone de suficientes ejemplos etiquetados. Su calidad depende, en gran medida, de que esos datos sean precisos y representativos.
Aprendizaje no supervisado
En el aprendizaje no supervisado, los datos no incluyen respuestas etiquetadas. El modelo busca por sí mismo estructuras, relaciones o patrones dentro de la información.
Algunas de sus aplicaciones más comunes son:
- Agrupamiento o clustering: organiza elementos similares en grupos. Puede ayudar a segmentar clientes según sus hábitos de compra.
- Reducción de dimensionalidad: resume conjuntos de datos complejos para facilitar su análisis o visualización.
- Detección de anomalías: localiza comportamientos inusuales, como transacciones que podrían ser fraudulentas.
Este enfoque resulta especialmente práctico cuando hay muchos datos, pero no es viable etiquetarlos manualmente. Sin embargo, interpretar los patrones encontrados puede requerir conocimientos del ámbito en el que se aplica.
Aprendizaje semisupervisado
El aprendizaje semisupervisado combina una pequeña cantidad de datos etiquetados con un conjunto mayor de datos sin etiquetar. El modelo utiliza ambos para aprender, aprovechando las etiquetas disponibles sin depender de que todos los ejemplos estén clasificados.
Puede ser una buena opción en campos donde etiquetar información exige tiempo o la intervención de especialistas, como el análisis de imágenes médicas, documentos o grabaciones de audio.
Aprendizaje autosupervisado
En el aprendizaje autosupervisado, el sistema obtiene señales de entrenamiento a partir de los propios datos, sin que una persona tenga que etiquetar cada ejemplo. Por ejemplo, puede aprender a predecir una palabra que falta en una frase o una parte oculta de una imagen.
Este método se utiliza para entrenar modelos con grandes cantidades de texto, imágenes, audio y otros contenidos. Después, el modelo puede adaptarse a tareas concretas mediante un ajuste adicional.
Aprendizaje por refuerzo
En el aprendizaje por refuerzo, un agente aprende interactuando con un entorno. En cada paso realiza una acción y recibe una recompensa o una penalización, de acuerdo con el resultado. Con el tiempo, aprende qué decisiones le ayudan a alcanzar un objetivo.
Se emplea, por ejemplo, en robótica, videojuegos, optimización de procesos y sistemas de control. A diferencia del aprendizaje supervisado, no siempre existe una respuesta correcta para cada situación: el agente debe descubrir una estrategia mediante la experiencia.
¿Y el aprendizaje profundo?
El aprendizaje profundo, o deep learning, no suele considerarse un tipo independiente según la forma de supervisión. Es un conjunto de técnicas basadas en redes neuronales con muchas capas, que pueden aplicarse en tareas supervisadas, no supervisadas, autosupervisadas o de refuerzo.
Estas técnicas son especialmente eficaces en problemas complejos relacionados con imágenes, lenguaje, sonido y vídeo, aunque suelen requerir grandes cantidades de datos y recursos de computación.
¿Qué tipo de aprendizaje automático elegir?
La elección depende del objetivo, de los datos disponibles y del nivel de supervisión posible. Si se conocen las respuestas correctas para muchos ejemplos, el aprendizaje supervisado puede ser adecuado. Si se busca descubrir grupos o patrones sin etiquetas, puede convenir el aprendizaje no supervisado. Cuando solo se dispone de unas pocas etiquetas, el enfoque semisupervisado puede ayudar; y si el sistema debe aprender mediante la interacción con un entorno, puede plantearse el aprendizaje por refuerzo.
En la práctica, algunos proyectos combinan varios enfoques. La calidad y representatividad de los datos, junto con una evaluación rigurosa, son fundamentales para que el modelo sea útil y fiable.
Conclusión
Los principales tipos de aprendizaje automático son el supervisado, el no supervisado, el semisupervisado, el autosupervisado y el aprendizaje por refuerzo. Cada uno responde a necesidades diferentes y ofrece distintas formas de enseñar a un sistema a partir de los datos. Comprender sus características facilita elegir el enfoque más apropiado para cada problema.
Cinco Ventajas de los Tipos de Aprendizaje Automático: Resolución de Problemas, Uso de Datos, Automatización, Diversidad de Aplicaciones y Toma de Decisiones
- Permiten resolver problemas de distintas formas.
- Aprovechan datos etiquetados y no etiquetados.
- Automatizan tareas y mejoran la eficiencia.
- Se aplican en sectores muy diversos.
- Facilitan predicciones y decisiones basadas en datos.
Desafíos en los Tipos de Aprendizaje Automático: Supervisado, No Supervisado, Semisupervisado, Autosupervisado y por Refuerzo
- El aprendizaje supervisado requiere datos etiquetados.
- El no supervisado puede ser difícil de interpretar.
- El semisupervisado depende de etiquetas fiables.
- El autosupervisado puede aprender sesgos de los datos.
- El aprendizaje por refuerzo puede requerir mucho tiempo y recursos.
Permiten resolver problemas de distintas formas.
Los distintos tipos de aprendizaje automático permiten abordar un mismo problema desde perspectivas diferentes, según los datos disponibles y el objetivo que se quiera alcanzar. Por ejemplo, se puede entrenar un modelo con respuestas conocidas, buscar patrones sin etiquetas o enseñarle a tomar decisiones mediante recompensas. Esta variedad facilita elegir el método más adecuado para cada situación y crear soluciones más flexibles y eficaces.
Aprovechan datos etiquetados y no etiquetados.
Una de las ventajas de algunos tipos de aprendizaje automático, como el semisupervisado, es que aprovechan tanto los datos etiquetados como los que no lo están. Así, el modelo puede aprender de un conjunto reducido de ejemplos clasificados y complementar ese conocimiento con una mayor cantidad de datos sin etiquetar. Esto reduce la necesidad de anotación manual, que puede ser costosa y laboriosa, y permite sacar más partido de la información disponible.
Automatizan tareas y mejoran la eficiencia.
Los distintos tipos de aprendizaje automático permiten automatizar tareas que, de otro modo, requerirían mucho tiempo y trabajo manual, como clasificar información, detectar patrones o realizar predicciones. Al procesar grandes volúmenes de datos con rapidez y consistencia, estos sistemas ayudan a reducir errores, agilizar los procesos y liberar a los equipos para que puedan centrarse en actividades de mayor valor.
Se aplican en sectores muy diversos.
Los distintos tipos de aprendizaje automático se aplican en sectores muy diversos porque pueden adaptarse a necesidades y datos diferentes. En sanidad, ayudan a analizar imágenes y detectar posibles riesgos; en finanzas, contribuyen a identificar operaciones sospechosas; en comercio, permiten anticipar la demanda y personalizar recomendaciones; y en industria, facilitan la automatización y el mantenimiento predictivo. Esta versatilidad convierte el aprendizaje automático en una herramienta útil para mejorar procesos y apoyar la toma de decisiones en numerosos ámbitos.
Facilitan predicciones y decisiones basadas en datos.
Los distintos tipos de aprendizaje automático permiten analizar grandes volúmenes de datos, identificar patrones y utilizarlos para anticipar resultados. Así, empresas y organizaciones pueden tomar decisiones más fundamentadas, desde prever la demanda de un producto hasta detectar posibles fraudes, adaptando el método a los datos disponibles y al objetivo que desean alcanzar.
El aprendizaje supervisado requiere datos etiquetados.
Una de las principales limitaciones del aprendizaje supervisado es que necesita datos etiquetados para entrenar el modelo, es decir, ejemplos acompañados de la respuesta correcta. Preparar estas etiquetas puede requerir mucho tiempo y recursos, especialmente cuando hace falta la revisión de especialistas. Además, si las etiquetas contienen errores o no representan bien la realidad, el modelo puede aprender patrones incorrectos y ofrecer predicciones poco fiables.
El no supervisado puede ser difícil de interpretar.
Una de las principales limitaciones del aprendizaje no supervisado es que sus resultados pueden ser difíciles de interpretar. Como el modelo identifica patrones sin contar con respuestas etiquetadas, los grupos o relaciones que descubre no siempre tienen un significado evidente. Por eso, suele ser necesario que una persona experta analice los resultados y determine si son relevantes y útiles para el problema planteado.
El semisupervisado depende de etiquetas fiables.
El aprendizaje semisupervisado depende de que las etiquetas disponibles sean fiables y representativas. Si contienen errores, sesgos o no reflejan adecuadamente el conjunto de datos, el modelo puede aprender patrones equivocados y extenderlos también a los ejemplos sin etiquetar. Por eso, aunque este enfoque reduce la necesidad de clasificar manualmente todos los datos, conviene revisar cuidadosamente las etiquetas y evaluar los resultados antes de utilizar el modelo.
El autosupervisado puede aprender sesgos de los datos.
El aprendizaje autosupervisado puede reproducir e incluso amplificar los sesgos presentes en los datos con los que se entrena. Como genera sus propias señales de aprendizaje a partir de esos datos, no siempre resulta fácil detectar qué prejuicios o desequilibrios está incorporando el modelo. Por ejemplo, si los textos de entrenamiento contienen estereotipos o representan de forma desigual a determinados grupos, el sistema podría reflejar esos patrones en sus respuestas. Para reducir este riesgo, es importante revisar la composición de los datos, evaluar el modelo con distintos grupos y supervisar sus resultados antes de aplicarlo.
El aprendizaje por refuerzo puede requerir mucho tiempo y recursos.
Una de las principales desventajas del aprendizaje por refuerzo es que puede requerir mucho tiempo y recursos para entrenar un modelo. El agente necesita interactuar repetidamente con el entorno y probar distintas acciones antes de encontrar una estrategia eficaz. Estas pruebas pueden implicar un alto coste computacional y, en aplicaciones reales, resultar lentas o arriesgadas, especialmente si los errores tienen consecuencias importantes.

Leave a Reply