Tipos de aprendizaje automático: guía de sus principales enfoques y aplicaciones
Tipos de aprendizaje automático: cuáles son y cómo se utilizan
El aprendizaje automático, también conocido como machine learning, es una rama de la inteligencia artificial que permite a los sistemas aprender a partir de datos y mejorar su rendimiento sin tener que programar cada regla de forma explícita. Se utiliza en aplicaciones tan cotidianas como las recomendaciones de películas, los filtros de correo no deseado y el reconocimiento de voz.
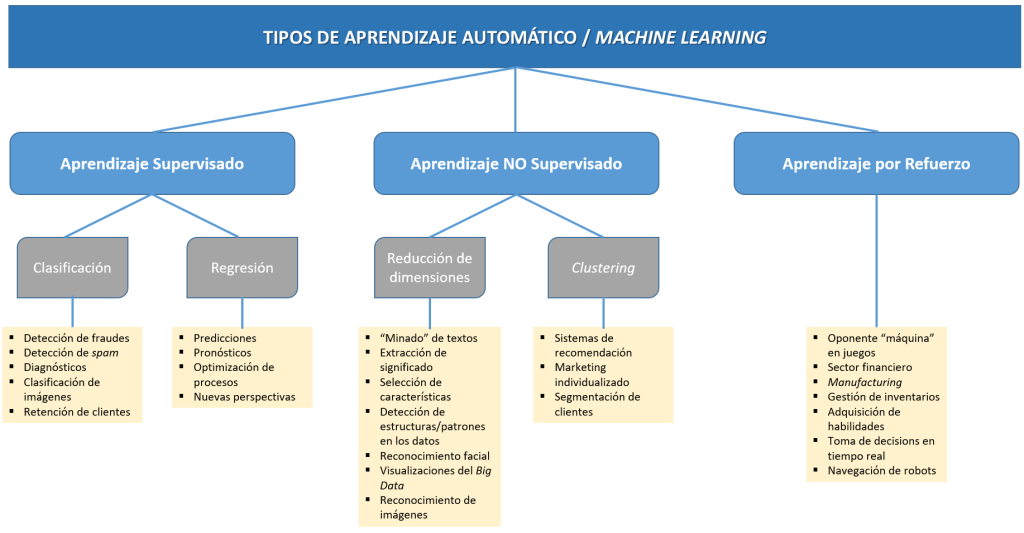
Existen varios tipos de aprendizaje automático. La diferencia principal entre ellos está en cómo reciben los datos y qué información tienen disponible durante el proceso de aprendizaje.
Aprendizaje supervisado
En el aprendizaje supervisado, el modelo se entrena con ejemplos que incluyen tanto los datos de entrada como la respuesta correcta, también llamada etiqueta. Al analizar esos ejemplos, aprende a realizar predicciones sobre datos nuevos.
Por ejemplo, se puede entrenar un sistema con fotografías etiquetadas como «gato» o «perro». Después, el modelo podrá clasificar imágenes que no había visto antes.
Las tareas más habituales de este tipo de aprendizaje son:
- Clasificación: asignar una categoría, como identificar si un correo es legítimo o no deseado.
- Regresión: predecir un valor numérico, como el precio estimado de una vivienda.
El aprendizaje supervisado se emplea en la detección de fraudes, los diagnósticos asistidos, la predicción de ventas y el análisis de opiniones, entre otros ámbitos.
Aprendizaje no supervisado
En el aprendizaje no supervisado, los datos no vienen acompañados de etiquetas. El sistema busca por sí mismo patrones, grupos o estructuras dentro de la información.
Una aplicación común es la segmentación de clientes. Un modelo puede agrupar a personas con comportamientos de compra similares sin que se le indique previamente qué grupos debe encontrar. También se utiliza para detectar anomalías o resumir grandes conjuntos de datos.
Entre sus técnicas más conocidas se encuentran:
- Agrupamiento o clustering: organiza los datos en grupos según sus semejanzas.
- Reducción de dimensionalidad: simplifica conjuntos de datos con muchas variables, conservando la información más relevante.
- Detección de anomalías: identifica observaciones que se alejan de los patrones habituales.
Aprendizaje semisupervisado
El aprendizaje semisupervisado combina una cantidad pequeña de datos etiquetados con un conjunto más amplio de datos sin etiquetar. Puede ser útil cuando etiquetar información requiere mucho tiempo, conocimientos especializados o un coste elevado.
Por ejemplo, en el análisis de imágenes médicas, especialistas pueden etiquetar una selección reducida de imágenes y utilizarla junto con muchas otras sin clasificar para entrenar el modelo. Este enfoque busca aprovechar ambos tipos de datos, aunque su eficacia depende de su calidad y de cómo se hayan seleccionado.
Aprendizaje por refuerzo
En el aprendizaje por refuerzo, un agente aprende a tomar decisiones interactuando con un entorno. Cada acción puede generar una recompensa o una penalización, y el objetivo es encontrar una estrategia que acumule la mayor recompensa posible a lo largo del tiempo.
Este enfoque se utiliza, por ejemplo, para entrenar sistemas que juegan a videojuegos, controlar robots o gestionar determinados procesos. El modelo aprende mediante la experiencia, por lo que suele ser importante definir cuidadosamente las recompensas: una señal mal planteada puede llevar a comportamientos no deseados.
Aprendizaje autosupervisado
El aprendizaje autosupervisado permite crear señales de entrenamiento a partir de los propios datos. En lugar de depender de etiquetas elaboradas manualmente, el sistema resuelve tareas diseñadas para aprender relaciones y representaciones útiles.
Por ejemplo, un modelo de lenguaje puede aprender a predecir una palabra que falta en una frase. Este tipo de aprendizaje se utiliza para entrenar modelos que después pueden adaptarse a tareas como resumir textos, responder preguntas o clasificar documentos.
¿Qué tipo de aprendizaje automático conviene elegir?
La elección depende del objetivo, de los datos disponibles y de los recursos del proyecto. Si se conocen las respuestas correctas para los ejemplos de entrenamiento, puede ser adecuado el aprendizaje supervisado. Si se quieren descubrir grupos o patrones sin etiquetas, puede convenir el aprendizaje no supervisado. Cuando solo se dispone de unas pocas etiquetas, el enfoque semisupervisado puede ser una opción. Para problemas de toma de decisiones mediante interacción, se puede valorar el aprendizaje por refuerzo.
En la práctica, muchos proyectos combinan distintas técnicas. Además, el éxito de un modelo no depende únicamente del algoritmo: también influyen la calidad de los datos, la definición del problema, la evaluación de los resultados y el seguimiento del sistema una vez puesto en marcha.
Conclusión
Los principales tipos de aprendizaje automático —supervisado, no supervisado, semisupervisado, por refuerzo y autosupervisado— ofrecen maneras distintas de aprender a partir de los datos. Comprender sus diferencias ayuda a elegir el enfoque más adecuado para cada necesidad y a diseñar soluciones de inteligencia artificial más útiles y fiables.
Preguntas Frecuentes sobre Tipos de Aprendizaje Automático: Conceptos, Métodos y Modelos
- ¿Qué es el aprendizaje automático y cuáles son sus características fundamentales?
- ¿Cuáles son los 3 tipos de machine learning?
- ¿Cuáles son los 4 tipos de métodos de aprendizaje?
- ¿Cuáles son los 5 tipos de aprendizaje?
- ¿Qué es un modelo de aprendizaje automático?
- ¿Cuáles son los modelos de machine learning?
¿Qué es el aprendizaje automático y cuáles son sus características fundamentales?
El aprendizaje automático es una rama de la inteligencia artificial que permite a los sistemas aprender a partir de datos y mejorar su rendimiento sin necesidad de programar cada paso de forma explícita. Sus características fundamentales son la capacidad de identificar patrones, construir modelos a partir de ejemplos y utilizar esos modelos para hacer predicciones o tomar decisiones ante nuevos datos. Según el método empleado, puede aprender con datos etiquetados, descubrir patrones sin etiquetas o mejorar mediante la interacción con un entorno y la recepción de recompensas o penalizaciones.
¿Cuáles son los 3 tipos de machine learning?
Los tres tipos principales de *machine learning* suelen ser el aprendizaje supervisado, el no supervisado y el aprendizaje por refuerzo. En el supervisado, el modelo aprende con ejemplos etiquetados para predecir resultados; en el no supervisado, analiza datos sin etiquetas para encontrar patrones o grupos; y, en el aprendizaje por refuerzo, aprende a tomar decisiones mediante la interacción con un entorno y las recompensas o penalizaciones que recibe. Aunque esta clasificación es la más habitual, también existen enfoques como el aprendizaje semisupervisado y el autosupervisado.
¿Cuáles son los 4 tipos de métodos de aprendizaje?
Los cuatro tipos de métodos de aprendizaje automático más habituales son el aprendizaje supervisado, que utiliza datos etiquetados; el no supervisado, que encuentra patrones en datos sin etiquetar; el semisupervisado, que combina una pequeña cantidad de datos etiquetados con muchos sin etiquetar; y el aprendizaje por refuerzo, en el que un sistema aprende a tomar decisiones mediante recompensas o penalizaciones. La elección depende del objetivo y de los datos disponibles.
¿Cuáles son los 5 tipos de aprendizaje?
Los cinco tipos principales de aprendizaje automático son el aprendizaje supervisado, que utiliza datos etiquetados; el no supervisado, que busca patrones en datos sin etiquetar; el semisupervisado, que combina ambos; el aprendizaje por refuerzo, en el que un sistema aprende mediante recompensas y penalizaciones; y el autosupervisado, que genera señales de aprendizaje a partir de los propios datos. Cada tipo se adapta a diferentes objetivos y a la información disponible.
¿Qué es un modelo de aprendizaje automático?
Un modelo de aprendizaje automático es un sistema matemático que aprende patrones a partir de datos para realizar una tarea, como clasificar imágenes, detectar fraude o predecir ventas. Durante el entrenamiento, ajusta sus parámetros según los ejemplos disponibles; después, utiliza lo aprendido para generar predicciones o tomar decisiones sobre datos nuevos. La calidad de sus resultados depende, entre otros factores, de la cantidad y calidad de los datos y de que el modelo sea adecuado para el problema.
¿Cuáles son los modelos de machine learning?
Los modelos de *machine learning* son algoritmos que aprenden patrones a partir de datos para realizar predicciones o tomar decisiones. Entre los más utilizados se encuentran la regresión lineal y logística, los árboles de decisión, los bosques aleatorios, las máquinas de vectores de soporte (SVM), los modelos de *k* vecinos más cercanos (KNN), los métodos de agrupamiento como *k*-means y las redes neuronales. La elección depende del problema: algunos modelos sirven para clasificar datos, otros para predecir valores y otros para descubrir grupos o patrones sin etiquetas.

Leave a Reply